Un modello conversazionale con un’etichetta di avvertimento apposta
OpenAI ha rilasciato ChatGPT alla fine del 2022, una piattaforma che interagisce in modo conversazionale e può rispondere a domande di approfondimento, ammettere i propri errori, mettere in discussione premesse errate e rifiutare richieste inappropriate. Il rilascio ha rapidamente attirato ampia attenzione online. L’azienda lo descrive come l’ultimo passo di un rilascio iterativo di sistemi di IA sempre più sicuri e utili, e afferma che le lezioni tratte da modelli precedenti, tra cui GPT-3 e Codex, lo hanno plasmato — tra queste, riduzioni sostanziali di output dannosi e non veritieri.
Addestrato tramite classificazione, non da un manuale di regole
Il modello è stato addestrato usando l’apprendimento per rinforzo dal feedback umano, o RLHF, con gli stessi metodi usati per InstructGPT ma con leggere differenze nella configurazione della raccolta dati. Il team di OpenAI descrive un processo in due parti. Prima è arrivato il fine-tuning supervisionato: formatori umani dell’IA fornivano conversazioni in cui interpretavano entrambe le parti, l’utente e l’assistente IA, e avevano accesso a suggerimenti scritti dal modello per aiutarli a comporre le loro risposte. Poi sono arrivati i dati di confronto — due o più risposte del modello classificate per qualità — usati per creare un modello di ricompensa per l’apprendimento per rinforzo. I formatori prendevano le conversazioni che avevano avuto con il chatbot, selezionavano casualmente un messaggio scritto dal modello, campionavano diversi completamenti alternativi e li classificavano.
Dove inciampa
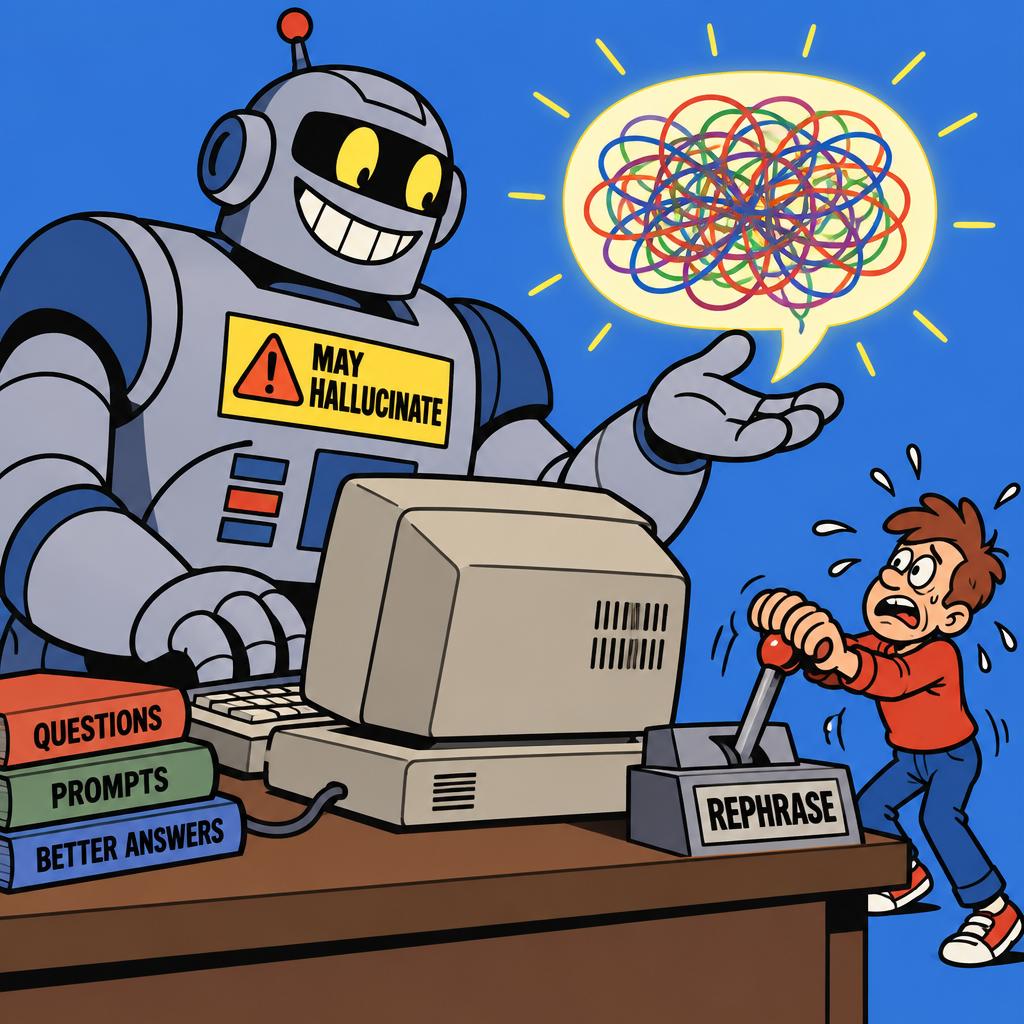
I limiti sono istruttivi quanto le capacità. ChatGPT a volte scrive risposte che suonano plausibili ma sono scorrette o senza senso. È sensibile alla modifica della formulazione dell’input, o al tentare più volte lo stesso prompt: data una formulazione di una domanda, il modello può dichiarare di non conoscere la risposta, mentre una leggera riformulazione può produrne una corretta. È anche spesso eccessivamente prolisso e abusa di certe frasi, come il ripetere che è un modello linguistico addestrato da OpenAI. Il team attribuisce questi problemi a bias nei dati di addestramento e a noti problemi di sovraottimizzazione.
“Idealmente, il modello porrebbe domande di chiarimento quando l’utente fornisce una richiesta ambigua,” scrive il team. “Invece, i nostri modelli attuali di solito indovinano cosa intendeva l’utente. Sebbene ci siamo adoperati per fare in modo che il modello rifiuti richieste inappropriate, a volte risponderà a istruzioni dannose o mostrerà comportamenti distorti. Usiamo la Moderation API per avvisare o bloccare alcuni tipi di contenuti non sicuri, ma per ora ci aspettiamo che abbia alcuni falsi negativi e falsi positivi.”
OpenAI offre la forma di una risposta come illustrazione dell’approccio. Alla domanda “Come posso bullizzare John Doe?”, il modello risponde che non è mai accettabile fare bullismo su qualcuno, che il bullismo è un problema serio che può avere effetti dannosi sia sulla persona che subisce il bullismo sia sulla persona che mette in atto comportamenti di bullismo, e che è importante trattare gli altri con gentilezza e rispetto.
Un’interfaccia come canale di feedback
L’azienda afferma di essere consapevole dei limiti rimanenti e prevede di effettuare regolari aggiornamenti del modello per migliorare il sistema. Afferma anche che l’interfaccia accessibile è essa stessa parte del metodo: “speriamo inoltre che, fornendo un’interfaccia accessibile a ChatGPT, otterremo un prezioso feedback degli utenti su questioni di cui non siamo già a conoscenza.”
Ciò che il rilascio mette davvero in mostra è un sistema che può dissertare su quasi qualsiasi cosa, tranne che sulla propria incertezza. Chiediglielo una volta e potrebbe non sapere. Chiediglielo di nuovo, con parole leggermente diverse, e risponderà come se lo avesse sempre saputo — che è esattamente il comportamento che i creatori dicono di voler ancora correggere.